פייפליין ETL מוכן לפרודקשן: הנדסת נתונים מתחילה אחרי שהסקריפט עובד
התשובה הקצרה: קוד עובד עדיין אינו פייפליין עובד
פייפליין ETL מוכן לפרודקשן הוא מערכת שיודעת לבצע את עבודתה באופן עקבי, להתאושש מכשלים, למנוע כפילויות, להתריע על חריגות ולהסביר מה קרה בכל הרצה. אם סקריפט Python מצליח למשוך נתונים ולכתוב אותם ל-PostgreSQL, הוכחנו שהלוגיקה הבסיסית אפשרית. עדיין לא הוכחנו שהארגון יכול לסמוך עליה.
הפער הזה חשוב במיוחד כאשר הנתונים מזינים דוחות הנהלה, תהליכים פיננסיים, מודלי ML או סוכני AI. מודל מתקדם אינו מפצה על נתון חסר, רשומה כפולה או שינוי סכמה שלא זוהה. ככל ששכבת ה-AI נעשית לא דטרמיניסטית יותר, כך שכבת הנתונים שמתחתיה חייבת להיות צפויה, מבוקרת ומוסברת יותר.
הסימן לבשלות אינו שהפייפליין הצליח פעם אחת, אלא שהכשל הבא יהיה צפוי, מוגבל וניתן לשחזור.
זו אינה הבחנה סמנטית. היא קובעת אם תקלה תיפתר אוטומטית בתוך דקות, או תתגלה בבוקר מפני שסמנכל הכספים קיבל דוח ריק.
ארבעה תפקידים שאסור לערבב
אחת הטעויות הנפוצות היא להעמיס על סקריפט יחיד גם את הלוגיקה העסקית, גם את ניהול ההרצה וגם את ההתאוששות. בהתחלה זה נוח. בהמשך מתקבל קוד שקשה לבדוק, להעביר בין סביבות ולתחזק בלי האדם שכתב אותו.
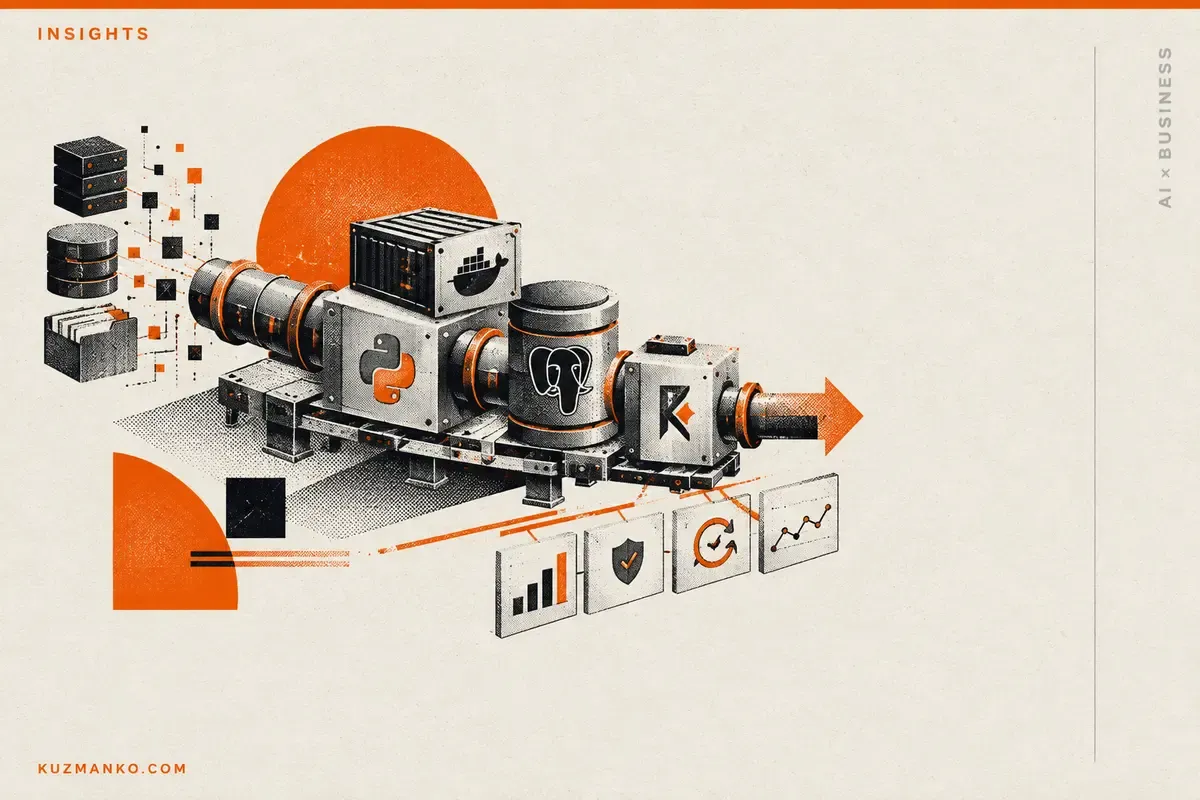
חלוקת אחריות נכונה נראית כך:
| שכבה | אחריות עיקרית | דוגמה | לא אמורה לנהל |
|---|---|---|---|
| יישום | שליפה, המרה וטעינה | Python | לוח זמנים ארגוני |
| מסד נתונים | עקביות ואילוצים | PostgreSQL | תזמור משימות |
| סביבת הרצה | תלויות וגרסאות | Docker | משמעות עסקית |
| תזמור | תזמון, retries ותלויות | Kestra או Airflow | פרסור הנתונים |
| תצפיתיות | לוגים, מדדים והתראות | מערכת ניטור | תיקון סמנטי אוטומטי |
ההפרדה מאפשרת להחליף רכיב בלי לפרק את המערכת. אפשר להעביר קונטיינר מסביבת פיתוח ל-CI או לענן, לשנות מתזמר, או לשדרג מסד נתונים בלי לכתוב מחדש את לוגיקת השליפה.
במילים פשוטות, Python צריך לדעת מה לבצע, המתזמר צריך לדעת מתי ואיך להפעיל, והמסד צריך להגן על אמינות התוצאה.
אידמפוטנטיות היא מנגנון התאוששות, לא קישוט הנדסי
מערכות ייצור נכשלות. רשת נקטעת, API מחזיר שגיאה זמנית, קונטיינר נעצר ומסד נתונים מגיע למגבלת חיבורים. לכן השאלה המקצועית אינה כיצד למנוע כל כשל, אלא כיצד לאפשר הרצה חוזרת בלי להשחית את הנתונים.
פייפליין אידמפוטנטי יכול לעבד שוב את אותו קלט בלי ליצור תוצאה כפולה או בלתי עקבית. ב-PostgreSQL אפשר להתחיל מאילוץ ייחודיות ופעולת upsert מפורשת:
INSERT INTO articles (source_id, title, published_at, content_hash)
VALUES (%s, %s, %s, %s)
ON CONFLICT (source_id)
DO UPDATE SET
  title = EXCLUDED.title,
  published_at = EXCLUDED.published_at,
  content_hash = EXCLUDED.content_hash;
ON CONFLICT DO NOTHING מתאים כאשר רשומה קיימת אינה אמורה להשתנות. DO UPDATE מתאים כאשר המקור עשוי לתקן או להעשיר אותה. ההחלטה אינה טכנית בלבד: היא מבטאת את המשמעות העסקית של הנתון ואת מדיניות ההיסטוריה שלו.
גם מפתח האידמפוטנטיות דורש מחשבה. מזהה שמגיע מהמקור עדיף בדרך כלל על כותרת או זמן קליטה. כאשר אין מזהה יציב, אפשר ליצור hash משדות שנבחרו במכוון. בחירה לא נכונה עלולה למחוק הבדלים אמיתיים או, להפך, לאפשר כפילויות.
retries בלי סיווג שגיאות עלולים להחמיר את התקלה
ניסיון חוזר הוא כלי חשוב, אבל אין טעם להריץ שוב קוד שנכשל בגלל סיסמה שגויה, עמודה חסרה או חוזה נתונים שהופר. retries מתאימים בעיקר לתקלות זמניות כמו timeout, הגבלת קצב או חוסר זמינות רגעי.
פייפליין בשל מבחין בין סוגי כשל:
- כשל זמני: ניסיון חוזר עם השהיה הולכת וגדלה.
- כשל קבוע: עצירה, תיעוד והתראה לבעלים.
- נתון פגום: העברה לאזור הסגר לצורך בדיקה.
- כשל חלקי: שמירת checkpoint וחידוש מנקודה בטוחה.
- שינוי סכמה: חסימה או הפעלה של מסלול תאימות מתוכנן.
בלי הסיווג הזה, המתזמר עלול להפעיל שוב ושוב עומס על שירות שכבר נמצא בתקלה. כך מנגנון שאמור לשפר אמינות הופך למכפיל נזק.
סדר בנייה שמצמצם את מרחב אי הוודאות
אין יתרון בהוספת Docker, תזמור וניטור לפני שלוגיקת ה-ETL עצמה הוכחה. מצד שני, אסור לדחות את שכבת התפעול עד סוף הפרויקט. הדרך הנכונה היא להתקדם בשכבות, כאשר לכל שלב יש תנאי קבלה ברור.
מוכיחים את הלוגיקה
מריצים שליפה, המרה וטעינה על קלטים תקינים וחריגים.
מגדירים עקביות
קובעים מפתחות, אילוצים, מדיניות עדכון והתנהגות בהרצה חוזרת.
אורזים סביבת הרצה
מקבעים גרסאות ותלויות בתוך קונטיינר שניתן להעביר בין סביבות.
מוסיפים תזמור
מגדירים תלויות, retries, timeout, backfill ולוחות זמנים.
מחברים תצפיתיות
מודדים טריות, נפח, שגיאות ומשך ומנתבים התראות לבעלים.
מתרגלים כשל
מנתקים מקור או מסד ובודקים שהמערכת מתאוששת כמתוכנן.
הסדר הזה מקצר איתור תקלות. אם הקוד כבר נבדק מקומית מול מסד אמיתי, תקלה שהופיעה לאחר האריזה ממוקדת יותר בסביבת ההרצה. אם הקונטיינר פועל באופן עקבי, תקלה לאחר החיבור למתזמר נבדקת קודם בהגדרות התזמון, בהרשאות ובתלויות.
מה חייבים לנטר בפועל
לוג שמודיע כי התהליך הסתיים אינו מספיק. ייתכן שההרצה הצליחה טכנית אך טענה אפס רשומות, קיבלה נתונים ישנים או השמיטה שדה עסקי קריטי. ניטור איכותי צריך לענות על שאלות עסקיות, לא רק על שאלות תשתית.
מדדי הבסיס צריכים לכלול:
- מועד ההרצה האחרונה שהושלמה בהצלחה.
- טריות הנתונים ביחס להתחייבות העסקית.
- מספר הרשומות שנקראו, נדחו, נוספו ועודכנו.
- משך כל שלב לעומת טווח ההתנהגות הרגיל שלו.
- שיעור ערכים חסרים בשדות קריטיים.
- מספר ניסיונות חוזרים וסיבת הכשל המקורית.
- גרסת הקוד, הקונטיינר והסכמה בכל הרצה.
כדאי להבחין בין הצלחה תפעולית לבין הצלחה עסקית. קונטיינר שחזר עם קוד יציאה תקין השיג הצלחה תפעולית. אם הדוח שאמור להתעדכן עד 07:00 עדיין מציג את נתוני אתמול, הפייפליין נכשל עסקית.
חוזי נתונים מונעים הפתעות בין צוותים
מקורות נתונים משתנים. ספק עשוי להחליף שם של שדה, מערכת פנימית עשויה לשנות טיפוס נתון, וצוות מוצר עשוי להפסיק לשלוח אירוע בלי להבין שהוא מזין דוח אחר. בדיקה ידנית לאחר התקלה אינה אסטרטגיה.
חוזה נתונים צריך להגדיר לפחות:
- אילו שדות חייבים להגיע.
- מהו הטיפוס והפורמט של כל שדה.
- אילו ערכים מותרים או בלתי סבירים.
- מי הבעלים של המקור ושל היעד.
- כיצד מודיעים על שינוי ובאיזה פרק זמן.
- מה קורה לנתון שאינו עומד בחוזה.
לא כל שינוי צריך להפיל את הפייפליין. שדה אופציונלי חדש יכול להירשם ולהמשיך. מחיקת מזהה עסקי קריטי צריכה לעצור טעינה או להעביר את המידע להסגר. ההבחנה דורשת ידע מקצועי בתהליך, לא רק היכרות עם ספריית Python.
העלות האמיתית נמצאת בתפעול
החלטות ארכיטקטורה צריכות להיבחן גם במונחי כסף וזמן. פייפליין שבנייתו מהירה אך דורש טיפול ידני שבועי עלול להיות יקר יותר ממערכת מעט מורכבת שמנהלת כשלים באופן צפוי.
לצורך החלטה ניהולית כדאי למדוד:
- שעות טיפול ידני בתקלות ובטעינות חוזרות.
- זמן ממוצע מגילוי תקלה עד התאוששות.
- עלות עסקית של נתון מאוחר או שגוי.
- מספר מערכות שתלויות בפלט.
- עלות backfill לאחר כשל ממושך.
- רמת התלות באדם יחיד שמכיר את הסקריפט.
הנדסת נתונים טובה מחליפה גבורה תפעולית במנגנונים. המטרה אינה להחזיק מהנדס שיודע להציל כל לילה, אלא מערכת שלא זקוקה להצלה ברוב הלילות.
כש-ETL מזין AI, רף הבקרה צריך לעלות
מערכות AI מוסיפות שכבה לא דטרמיניסטית לתהליך העסקי. לכן הן זקוקות לתשתית נתונים מתועדת במיוחד: lineage, גרסאות, הרשאות, מדדי איכות ויכולת לשחזר את הקלט שהוביל לתוצאה.
אדם בלולאה נשאר עיקרון קריטי, אך אין היגיון לדרוש מאדם לאשר כל רשומה או כל תשובה. תכנון נכון מאפשר למפקח אחד לטפל בחריגים רבים, במקום לבצע בעצמו כל תהליך. לשם כך הפייפליין צריך לסמן רמת ביטחון, סוג חריגה, מקור נתון והקשר עסקי ברור.
זהו גם המקום שבו ניסיון עסקי והשכלה מקצועית מקבלים משקל. AI והנדסת נתונים אינם אוסף טריקים טכניים. נדרשת הבנה של סטטיסטיקה, תוכנה, אבטחת מידע, תהליכים ארגוניים וניהול סיכונים. ייעוץ שטחי עשוי להפיק הדגמה מרשימה, אך הוא נחשף במהירות כאשר צריך להגדיר אחריות, חריגים, SLA או השפעה כספית.
אבטחה ובעלות אינן משימות לסוף הפרויקט
פייפליין נוגע לעיתים במידע רגיש ובכמה מערכות במקביל. לכן אסור להטמיע סיסמאות בתמונה, בקוד או בקובץ שמועבר בין מפתחים. סודות צריכים להישמר במנגנון ייעודי, הרשאות צריכות לפעול לפי עקרון המינימום, וכל גישה משמעותית צריכה להיות מתועדת.
מעבר לאבטחה, לכל פייפליין חייב להיות בעלים מזוהה. הבעלות אינה מסתכמת בשם צוות. צריך להיות ברור מי מקבל התראה, מי מוסמך להחליט על backfill, מי מאשר שינוי סכמה ומי מתקשר פגיעה לצרכני הנתונים.
מחלקות מערכות מידע ודאטה נדרשות כיום לנהל גם פייפליינים וגם סוכני AI ככוח עבודה דיגיטלי: הרשאות, גרסאות, ביצועים, עלויות ומחזור חיים. בלי פלטפורמה ארגונית לניהול הרכיבים האלה, מספר האוטומציות יגדל מהר יותר מהיכולת לשלוט בהן.
מבחן הקבלה הנכון לפרודקשן
לפני העלאה לייצור, לא מספיק לסמן שהפיתוח הסתיים. יש להוכיח התנהגות תחת תרחישים צפויים:
- אותה מנה נטענת פעמיים בלי ליצור כפילות.
- מקור הנתונים אינו זמין והמערכת מנסה שוב לפי מדיניות מוגדרת.
- שינוי בשדה קריטי מזוהה לפני טעינה שגויה.
- ניתן להריץ backfill לטווח שנבחר בלי לפגוע בנתונים קיימים.
- לוגים ומדדים מאפשרים לזהות באיזה שלב התרחש הכשל.
- ההתראה מגיעה לבעלים הנכון וכוללת הקשר לפעולה.
- ניתן לשחזר איזו גרסת קוד וסכמה יצרה כל תוצאה.
פייפליין שעובר את המבחנים האלה מתחיל להיות נכס תפעולי. עד אז הוא סקריפט מועיל, אולי אפילו כתוב היטב, אבל עדיין לא רכיב שהארגון צריך לבסס עליו החלטות.
ההחלטה הניהולית החשובה
ארגון אינו צריך את הכלי האופנתי ביותר. הוא צריך סטנדרט הנדסי אחיד שמגדיר כיצד בונים, מפרסמים, מנטרים ומתחזקים פייפליינים. Kestra, Airflow או מתזמר אחר יכולים לבצע את העבודה; Docker או חלופה מתאימה יכולים לייצב את סביבת ההרצה. הבחירה חשובה, אך המשמעת חשובה יותר.
הנדסת נתונים אמיתית מתחילה בנקודה שבה מפסיקים לשאול אם הסקריפט רץ, ומתחילים לשאול אם המערכת אמינה גם כאשר המפתח אינו צופה בה. שם נוצרת התשתית שעליה אפשר לבנות BI, אוטומציה ו-AI בלי להפוך כל תקלה לאירוע ארגוני.