מודל AI של 34.7 מיליארד פרמטרים על לפטופ: סדק בחומת ה-GPU
התשובה הקצרה: ה-GPU לא נעלם, אבל כבר אינו ברירת המחדל
היכולת להריץ מודל AI בעל 34.7 מיליארד פרמטרים על לפטופ אינה מבטלת את הצורך ב-GPU מתקדם. היא כן שוברת הנחה יקרה: שכל יישום ארגוני משמעותי מחייב ענן, מאיץ עוצמתי או השקעת תשתית גדולה כבר בתחילת הדרך.
החידוש החשוב סביב Ourbox-35B-JGOS ומנוע ההרצה VKUE אינו עצם הפעלת המודל, אלא הדרך שבה ארכיטקטורת Mixture of Experts, קוונטיזציה וניהול זיכרון מאפשרים להשתמש בכל טוקן רק בכ-3 מיליארד פרמטרים פעילים. התוצאה היא מודל גדול מבחינת היקף הידע והמבנה, אך חסכוני יותר בזמן ההסקה.
- פרמטרים במודל המלא
- 34.7 מיליארד
- פרמטרים פעילים לטוקן
- כ-3 מיליארד
- טוקנים לשנייה בלפטופ
- כ-20
- טוקנים לשנייה ב-CPU
- כ-17
המספרים האלה אינם מוכיחים שלפטופ יכול להחליף תשתית ייצור עמוסה. הם מוכיחים שאפשר להתחיל את הדיון העסקי במקום אחר: מהו התהליך, מהי רמת השירות הנדרשת, איזה מידע אסור להוציא מהארגון וכמה משתמשים יפעלו במקביל.
השינוי האמיתי אינו שמודל גדול נכנס ללפטופ. השינוי הוא שהארגון יכול להתאים חומרה לתהליך, במקום להתאים את התהליך לחומרה היקרה ביותר.
כיצד מודל גדול מתנהג כמו מודל קטן יותר
במודל צפוף, כל שכבה מפעילה חלק גדול מהפרמטרים בכל שלב של יצירת התשובה. הפעולה דורשת להעביר כמויות גדולות של נתונים מהזיכרון אל יחידות החישוב. בהסקת LLM, רוחב הפס של הזיכרון עשוי להפוך למגבלה משמעותית לא פחות מכוח החישוב עצמו.
מודל MoE פועל אחרת. הוא כולל קבוצות רבות של מומחים, אך מנגנון ניתוב בוחר בכל שלב רק חלק מהן. אם מתוך 34.7 מיליארד פרמטרים מופעלים כ-3 מיליארד לכל טוקן, היקף החישוב ותנועת הנתונים קטן באופן משמעותי.
עם זאת, חשוב לא לפשט יתר על המידה. פרמטרים לא פעילים אינם בהכרח פרמטרים שלא צריך לאחסן או לטעון. המשקולות המלאות עדיין דורשות מקום בזיכרון, באחסון או בשילוב ביניהם. גם חלון ההקשר, KV cache, הקוונטיזציה, מערכת ההפעלה וקצב העברת הנתונים משפיעים על הביצועים בפועל.
במילים אחרות, אין כאן קסם הנדסי. יש כאן תכנון חכם של פשרות.
הנתונים מרשימים, אך אינם בני השוואה מלאה
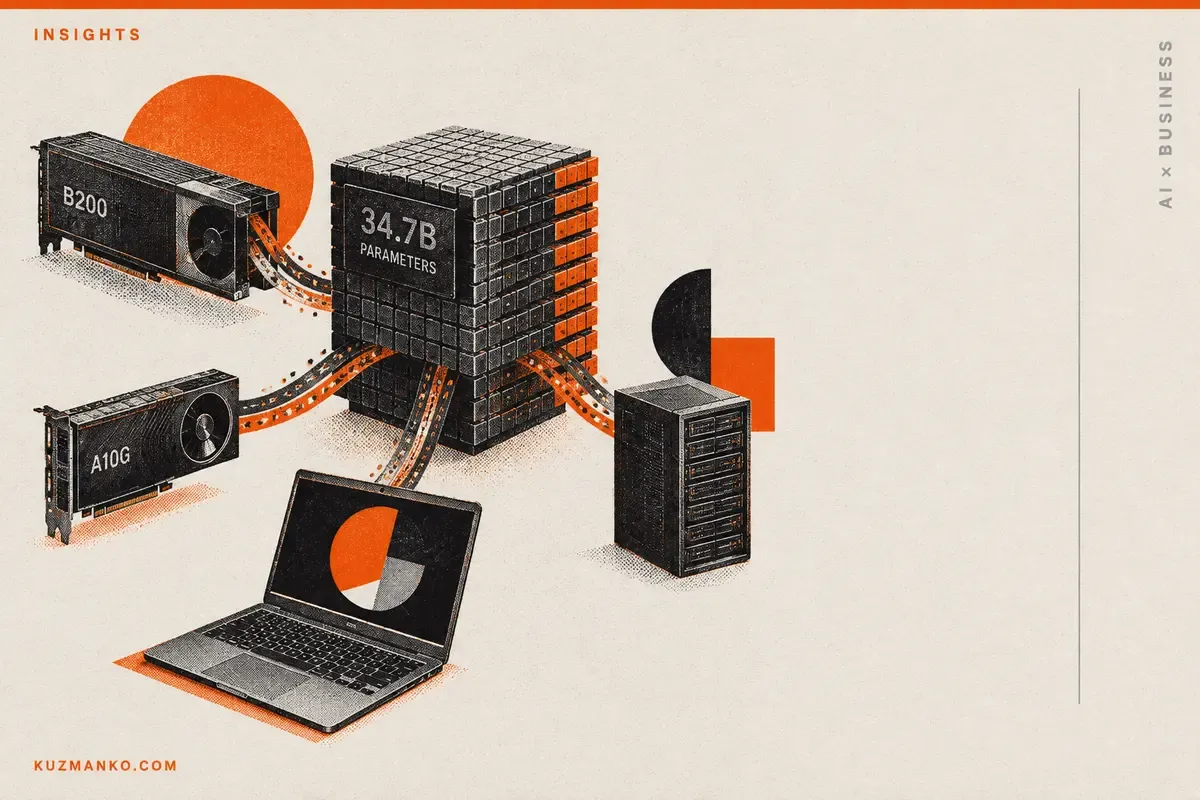
לפי התוצאות שפורסמו, אותו קובץ משקולות פעל על חומרה שנעה מ-B200 ועד שרת CPU בלבד. הפערים גדולים מאוד, אך גם סוג המדידה חשוב: תפוקה מצרפית תחת עומס אינה זהה למהירות של משתמש יחיד, וחומרות שונות עשויות להיבדק עם תצורות שונות של זיכרון, מקביליות ואורך הקשר.
התרשים ממחיש מדוע ה-GPU היוקרתי לא עומד להיעלם מעומסי AI גדולים. B200 משרת קטגוריה אחרת לגמרי של נפח ומקביליות. במקביל, 17 עד 20 טוקנים לשנייה עשויים להיות קצב שימושי לתהליכים מקומיים, כל עוד אין דרישה למאות משתמשים בו-זמנית או לזמני תגובה קשיחים.
| סביבת הרצה | יתרון מרכזי | מגבלה מרכזית | שימוש מתאים |
|---|---|---|---|
| GPU מתקדם | תפוקה ומקביליות | עלות ורכש | שירות רחב היקף |
| GPU צנוע | איזון ביצועים ועלות | קיבולת מוגבלת | צוות או מחלקה |
| לפטופ | ניידות ופרטיות | עומס מקביל נמוך | עבודה אישית ושטח |
| CPU בלבד | ניצול תשתית קיימת | השהיה גבוהה יותר | משימות רקע ואצווה |
לכן, טוקנים לשנייה אינם KPI עסקי בפני עצמו. ארגון צריך למדוד זמן לסגירת תהליך, שיעור חריגים, עלות לכל משימה, איכות התוצאה והיקף ההתערבות האנושית.
המשמעות לארגונים בישראל: יותר אפשרויות פריסה
השוק הישראלי כולל ארגונים רבים שפועלים תחת דרישות פרטיות, רגולציה, סודיות מסחרית או מגבלות קישוריות. בנקים, בתי חולים, תעשיות ביטחוניות, גופי ממשל, מפעלים וחברות עם פעילות שטח אינם יכולים תמיד להעביר מידע רגיש לשירות AI חיצוני.
הרצה מקומית יעילה עשויה לפתוח עבורם כמה תרחישים מעשיים:
- עיבוד מסמכים רגישים ללא שליחת התוכן לענן ציבורי.
- סיוע לעובדי שטח גם כאשר הקישוריות מוגבלת.
- הפעלת RAG מעל מאגר פנימי בסביבה מבודדת.
- סיווג, חילוץ ובקרת מסמכים על שרתים קיימים.
- יצירת שכבת AI מקומית למערכות תפעול ותיקות.
- שמירת יכולת עבודה בסיסית במקרה של תקלה בשירות חיצוני.
הערך אינו רק חיסכון בעלויות ענן. פריסה מקומית יכולה לשפר שליטה, שרידות וזמן תגובה. מנגד, היא מעבירה אחריות לארגון: עדכוני מודל, אבטחה, הרשאות, ניטור, בדיקות איכות וניהול גרסאות.
הסיכון: לרכוש חומרה לפני שמבינים את התהליך
ארגונים נוטים להתחיל בשאלה איזה GPU לקנות. זו בדרך כלל השאלה הלא נכונה. ההחלטה צריכה להתחיל במיפוי התהליך העסקי: מי מקבל החלטה, אילו נתונים זמינים, מה מחיר הטעות, כמה פעמים התהליך מתרחש ומה נחשב שיפור אמיתי.
AI אינו פרויקט טכני בלבד. מדובר בתחום מולטידיסציפלינרי שמחבר מדעי המחשב, הבנת תהליך, ניהול סיכונים, כלכלה ארגונית וחוויית משתמש. לכן השכלה רלוונטית וניסיון יישומי אינם קישוט. הם תנאי לבחירה נכונה של מודל, תשתית ומנגנוני בקרה.
זה חשוב במיוחד לעסקים קטנים ובינוניים, שעלולים לקבל המלצות נחרצות ממומחים מטעם עצמם. התקנת מודל מקומי נראית פשוטה בסרטון הדגמה, אך פתרון יציב דורש הבנה של זיכרון, קוונטיזציה, אבטחה, איכות תשובות, תפעול והקשר עסקי. בחירה שגויה עלולה לייצר עלות נסתרת גבוהה יותר משירות ענן מנוהל.
אדם בלולאה, אבל לא בכל פעולה
מודלים מקומיים יעילים מאפשרים לארגון להפעיל סוכני AI קרוב למערכות ולמידע. כאן נמצא פוטנציאל משמעותי להתייעלות תפעולית: AI יכול לבצע תהליכים לא דטרמיניסטיים שבעבר דרשו שיקול דעת אנושי, כגון בדיקת מסמך, זיהוי חריגה, ניסוח המלצה או ניתוב מקרה.
עם זאת, אדם בלולאה הוא רכיב קריטי רק כאשר הוא מתוכנן נכון. אם עובד נדרש לאשר כל פעולה של המודל, הארגון לא יצר אוטומציה אלא תור חדש של אישורים. המטרה היא שעובד שפיקח בעבר על תהליך יחיד יוכל לפקח על עשרות או מאות מופעים, תוך התמקדות בחריגים ובמקרים בעלי סיכון גבוה.
לשם כך נדרשים:
- ספי ביטחון שמפרידים בין פעולה אוטומטית להסלמה.
- מדיניות ברורה לגבי פעולות שהסוכן רשאי לבצע.
- תיעוד מלא של קלט, החלטה, כלי ותוצאה.
- ניטור חריגות במקום בדיקה ידנית של כל תשובה.
- אפשרות לעצירה, שחזור והעברה מהירה לאדם.
מתודולוגיה לבדיקת הרצה מקומית
במקום להכריז על מעבר לענן או ל-On-Prem, כדאי להריץ ניסוי ממוקד על תהליך אחד. הניסוי צריך להשוות תצורות, לא רק מודלים: שירות ענן, GPU מקומי, חומרה קיימת וגישה היברידית.
מגדירים תהליך
בוחרים משימה בעלת נפח, עלות, סיכון ומדד הצלחה ברורים.
יוצרים קו בסיס
מודדים זמן, איכות, חריגים ועלות בתהליך הקיים לפני הכנסת AI.
בודקים כמה תצורות
משווים ענן, GPU מקומי, CPU וחלופה היברידית באותם מקרי מבחן.
מעמיסים תרחיש אמיתי
בודקים מקביליות, הקשר ארוך, נפילות ותלות במערכות ארגוניות.
מתכננים פיקוח
מגדירים ספי אוטומציה, הסלמה, תיעוד ואחריות אנושית.
מחשבים עלות כוללת
כוללים חומרה, חשמל, תחזוקה, אבטחה, כוח אדם ושדרוגים.
הבדיקה צריכה להשתמש בנתוני אמת שעברו טיפול מתאים, ובסט משימות שמייצג את העבודה בפועל. מבחן כללי של שאלות ותשובות אינו מספיק כדי לבחור תשתית לתהליך פיננסי, רפואי, משפטי או תעשייתי.
שני מסלולים שצריכים להתקדם יחד
הוזלת ההרצה המקומית אינה פותרת את אתגר האימוץ. ארגון צריך להתקדם בשני מסלולים במקביל.
המסלול הראשון הוא אוריינות AI: עובדים ומנהלים צריכים ללמוד לתקשר עם מודלים, לזהות תשובה חלשה, להגן על מידע ולהבין מתי נדרש אימות. כלי AI אישיים יכולים לייצר ערך רב, אך הם דורשים שינוי בהרגלי העבודה.
המסלול השני הוא פיתוח סוכנים: שילוב AI בתוך תהליך קיים, כך שהעובד אינו נדרש לפתוח כלי נפרד וליזום כל פעולה. סוכן מתוכנן היטב יכול להשתלב בתיבת דואר, במערכת שירות, ב-ERP או בזרימת מסמכים. טכנית הוא עשוי להיות מורכב יותר, אך לעיתים קל יותר להטמיע אותו משום שהוא אינו משנה באופן דרמטי את חוויית העבודה.
כדי שהמסלול הזה יתרחב, חברות צריכות לפתח יכולת פנימית להקמה ולניהול של סוכני AI. מחלקות מערכות מידע יידרשו בהדרגה לנהל גם כוח עבודה דיגיטלי: הרשאות, תפקידים, ביצועים, חריגים, גרסאות והפסקת פעילות. במובן הזה, הן יהפכו למחלקת משאבי אנוש של הסוכנים.
האם עידן ה-GPU היקר מתחיל להיסדק?
כן, אבל לא מפני שמאיצים חזקים הפכו למיותרים. הסדק מופיע במקום אחר: בקשר האוטומטי בין מודל משמעותי לבין תשתית יקרה.
GPU מתקדם ימשיך להיות חיוני לאימון, לתפוקה גבוהה, למקביליות ולמודלים תובעניים. במקביל, מודלים דלילים, קוונטיזציה ומנועי הרצה יעילים ירחיבו את הטווח שבו לפטופים, תחנות עבודה ושרתי CPU יכולים לספק ערך אמיתי.
המשמעות הניהולית היא מעבר מרכש אחיד לארכיטקטורה מדורגת. משימות כבדות יכולות לרוץ בענן או על GPU מרכזי, מידע רגיש יכול להישאר בסביבה מקומית, ומשימות פשוטות יותר יכולות להתבצע בקצה. לא כל בקשה זקוקה לאותו מודל, לאותה חומרה או לאותה רמת שירות.
הארגונים שיפיקו מכך יתרון לא יהיו בהכרח אלה שיקנו את המאיץ החזק ביותר. אלה יהיו הארגונים שידעו לחבר בין ידע מקצועי עמוק, הנדסת AI, תהליך עסקי, פיקוח אנושי וכלכלת תשתיות. החומרה נעשית נגישה יותר. האחריות לתכנון נכון דווקא גדלה.