

טכניקות פרומפטינג (prompt) לפי משימה ומודל: כך תעשו את זה נכון יותר
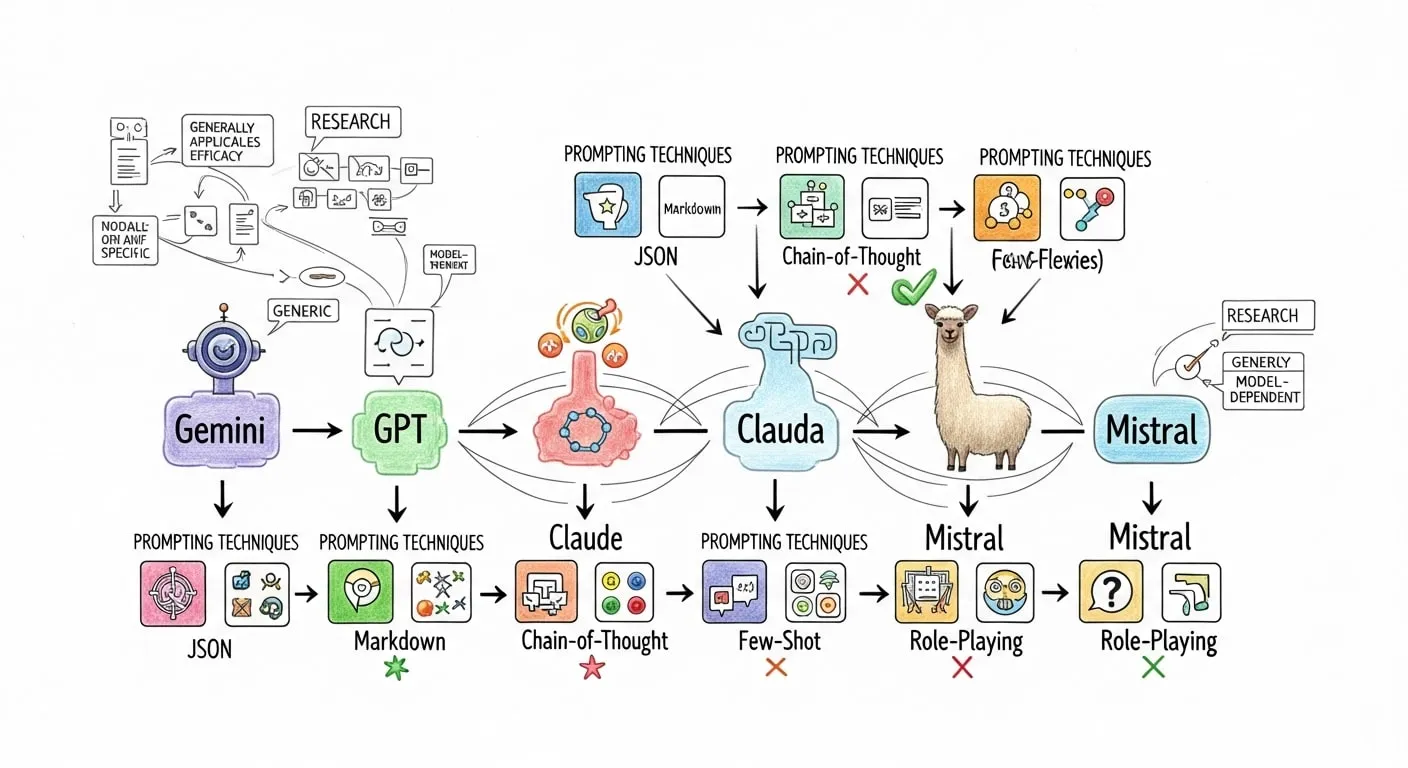
ארגונים רבים מגלים בשנת 2026 שטכניקות פרומפטינג אינן סט חוקים אוניברסלי, אלא מערכת החלטות שמושפעת מהמודל, מהמשימה ומהדרישה לפלט מובנה. מנהלים טכנולוגיים שואלים בצדק האם כדאי לנסח הנחיות ב- JSON, האם Markdown משפר דיוק, ומתי כדאי לבקש הסבר של שלבים. נתונים ממדידות עדכניות מראים שהתשובה משתנה בין GPT, Claude, Gemini, וגם בין מודלים בקוד פתוח כמו Llama ו Mistral. מסגרת החלטה נכונה חוסכת זמן, מפחיתה עלויות טוקנים, ומעלה אמינות במערכות פרודקשן.
פרומפטינג מתקדם לפי מודל ומשימה: פורמטים, דוגמאות, והיגיון
בחירה בין Zero Shot ל- Few Shot נשארת אחת ההחלטות בעלות ההשפעה הגבוהה ביותר. טכניקת Zero Shot יעילה כאשר צריך קנה מידה מהיר ועלות מינימלית, אך ביצועים נוטים לרדת במשימות תחומיות או כשנדרשת עקביות פורמט. טכניקת Few Shot, עם שתיים עד ארבע דוגמאות מכוונות, משפרת יציבות בעיקר בסיווג, מיפוי קטגוריות, וחילוץ ישויות. מקרה שימוש אחד הראה שקיצור זמן פיתוח כלי אבחוני ב 40 אחוז והעלאת שיעור אבחון מוקדם למחלות נדירות ב 30 אחוז הושגו באמצעות Few Shot במקום בנייה מחדש.
בקשות לחשיבה של שלבים, שנקראות לעיתים Chain of Thought, אינן מייצרות ערך זהה בכל מודל. מודלים שאינם ממוקדי היגיון מראים שיפור ממוצע של 11.7 אחוז עד 13.5 אחוז, אבל המחיר הוא עלייה של 35 אחוז עד 600 אחוז בזמן ובטוקנים. מודלים עם יכולות היגיון מובנות מראים שיפור קטן של 2 אחוז עד 3 אחוז בלבד, תוך תוספת זמן של 20 אחוז עד 80 אחוז. מסקנה מעשית מצביעה על כך שכדאי להפעיל זאת רק כשדיוק קריטי ובאמת נדרשת הנמקה, ולא כברירת מחדל.
שיטה חזקה למשימות היגיון היא Self Consistency, שבה מייצרים כמה נתיבי פתרון ובוחרים את התשובה היציבה ביותר. מחקרים מראים שביצועים נוטים להתרומם עד בערך 40 דגימות ואז קיימת תשואה שולית פוחתת. שימוש כזה מתאים לתרחישים עתירי סיכון כמו בדיקות תאימות, חשבונאות, או אימות תוצאות, אך העלות הליניארית במספר הדגימות מחייבת תמחור מראש וחלוקה בין מודלים.
תבנית JSON מול Markdown ומבנים חסכוניים בטוקנים: מתי כל פורמט מנצח?
פורמט JSON הוא כלי מרכזי כשמערכת צריכה חוזה פלט שניתן לאמת, למשל סיווג אוטומטי, חילוץ שדות, או יצירת אובייקטים לאינטגרציה. עם זאת, קיימת תופעה של מעבר להקשר טכני שמפחיתה איכות ביצירה חופשית, ולכן תוכן יצירתי נוטה להיפגע כאשר מכריחים אותו לתוך מפתחות וסוגריים. בנוסף קיימת תקורת טוקנים, שמורגשת במיוחד בדאטה טבלאי או חוזר.
השוואה אמפירית בין JSON ל Markdown הראתה תוצאה מפתיעה ותלויה במודל. מודל GPT ברמה גבוהה השיג 81.2 אחוז דיוק עם Markdown לעומת 73.9 אחוז עם JSON, פער של 7.3 נקודות. מודל חלש יותר באותה משפחה השיג 59.7 אחוז עם JSON לעומת 50.0 אחוז עם Markdown. המשמעות היא שפורמט Markdown יכול לעזור למודלים מתקדמים להפריד הנחיות, אילוצים, ושלבים, בעוד שמודלים חלשים יותר נהנים מהנחיות חדות בפורמט קשיח.
פורמט חסכוני בטוקנים כמו TOON מציג יתרון כלכלי כשמזרימים נתונים שטוחים וחוזרים. דוגמה מדידה הראתה שטבלת 500 שורות דרשה 11,842 טוקנים ב JSON לעומת 4,617 טוקנים ב TOON, כלומר חיסכון של 61 אחוז.
בדיקות הבנה סמנטית הראו דמיון קוסיני ממוצע של 0.991 בין תוצרים עם JSON לבין TOON, מה שמרמז שהחיסכון אינו פוגע בהבנה. תרחישים עם קינון עמוק ומפתחות הטרוגניים מציגים חיסכון נמוך משמעותית, ולעיתים רק סביב 3 אחוז.
יישום פרודקשני מתקדם מסתמך פחות על בקשה כללית ל JSON ויותר על אכיפת סכמות באמצעות Structured Outputs או כלים, שמבטיחים נוכחות שדות וטיפוסים ולא רק תחביר. גישה זו מתאימה במיוחד לתהליכים אוטומטיים, ניטור, וולידציה, והיא מצמצמת תקלות פריסה שנובעות מפלט חלקי או לא עקבי.
התאמות לפי משפחות מודלים: GPT, Claude, Gemini, Llama ו Mistral
משפחת GPT מצטיינת בעמידה בפורמט ובציות להנחיות, ובמודלים מתקדמים מתקבלת תועלת גבוהה מהיררכיה ברורה בסגנון Markdown. במקביל, פורמט JSON נוח לאינטגרציה אך עלול להחליש איכות כשמבקשים טקסט שיווקי או נרטיבי. נתוני בטיחות ודיוק מצביעים על פערי דורות, עם עלייה של 40 אחוז בדיוק עובדתי בין דורות מרכזיים וירידה של 82 אחוז בנטייה לתוכן לא בטוח, מה שמאפשר לקצר פרומפטים ולהישען יותר על מנגנונים מערכתיים.
מודלי Claude נוטים להצטיין בהנחיות מפורשות, בדקדוק דרישות, ובהפרדה חדה בין הקשר למשימה. ארגונים רבים מדווחים שתגיות בסגנון XML מסייעות להבדיל בין מדיניות, קלט לא אמין, ומטלות, בעיקר בתהליכי כלי פיתוח וקוד. שיטת עבודה יעילה עם Claude כוללת איטרציות קצרות, שמירה על החלטות ארכיטקטוניות, וכיווץ הקשר בין חלונות, כדי לא לאבד רציפות בפרויקטים ארוכים.
מודלי Gemini מכוונים למהירות ולחלונות הקשר ענקיים, ולכן סדר הפרומפט חשוב במיוחד. הקשר גדול מומלץ להופיע תחילה, והדרישה המדויקת בסוף, כדי לשפר מיקוד. פרומפטים שמפרקים משימה לרכיבים קטנים מסייעים להימנע מדרישות מרובות באותה שורה. סביבת Gemini נהנית גם מהגדרת רמת פירוט רצויה, כדי למנוע תשובות קצרות מדי או ארוכות מדי.
מודלים בקוד פתוח כמו Llama ו Mistral מגיבים טוב להנחיות מפורטות, לכללים מפורשים, ולדוגמאות ממוקדות, במיוחד בסיווג ובחילוץ. שימוש בפורמט מובנה ובשפה אובייקטיבית, למשל הגדרת אורך מדויק או תבנית פלט, מפחית סטיות. ארגונים שבוחרים פריסה מקומית מוסיפים לרוב שכבת ולידציה, רישום לוגים, ופרומפטים קשיחים יותר כדי לפצות על שונות בין גרסאות וקונפיגורציות.
סיכום מעשי והצעד הבא לארגון
החלטות פרומפטינג אפקטיביות נשענות על התאמה בין מודל, משימה ודרישת פלט, ולא על רשימת טיפים כללית. קווי פעולה מומלצים מתחילים בבחירה בין Few Shot לבין Zero Shot, ממשיכים בבחירת פורמט בין JSON לבין Markdown או מבנים חסכוניים בטוקנים, ומסתיימים באכיפת סכמות כשנדרש חוזה מכונה. ארגון שמודד עלות טוקנים, זמן תגובה, ודיוק לאורך זמן יכול להשיג חיסכון של 30 אחוז עד 50 אחוז באמצעות קיצור פרומפטים, וחיסכון של עד 70 אחוז בגודל הקשר באמצעות RAG, תוך שמירה על איכות. צוותים שמבקשים לממש פרומפטינג מתקדם בפרודקשן יכולים להתחיל בפיילוט קטן לכל מודל מרכזי, למדוד JSON Compliance, דיוק, ועלות, ולבנות ספריית פרומפטים מאושרת לפי משימות נפוצות.


